5.18. Ermittlung der MC-Verteilungen und daraus abgeleiteter Kenngrößen im Detail
Bei der Monte Carlo Simulation werden nacheinander drei verschiedene Verteilungen erzeugt, aus denen jeweils bestimmte Kennwerte abgeleitet werden. Bei den abgeleiteten Kennwerten handelt es sich neben arithmetischem Mittelwert und Standardabweichung der Verteilung vor allem um bestimmte Quantile.
Am Beginn wird die (große) Anzahl N von simulierten Messwerten der Ergebnisgröße festgelegt. Dies definiert einen „Run”. Es können mehrere „Runs” (Anzahl r; maximal 50) gerechnet werden, so dass mit den jeweils erhaltenen Kenngrößen statistische Auswertungen gemacht werden können; man erhält aus der r-fachen Wiederholung der Simulation z.B. mit der Standardabweichung eine statistische Angabe über die Unsicherheit der erhaltenen Kennwerte.
Ermittlung eines Quantils
Das bisher in UR2 benutzte MC-Verfahren war primär für das Vorliegen nahezu symmetrischer Verteilungen der Ergebnisgröße ausgelegt. Mit der Anwendung des GUM Supplements 1 können nicht-symmetrische Verteilungen bestimmter Eingangsgrößen zu einer asymmetrischen Verteilung der Ergebnisgröße führen. Hierfür erwies sich das bisher benutzte Verfahren, für das vor der Simulation die zu erwartenden Extremwerte im Programm festzulegen waren, als nachteilig.
Daher wurde mit Version 2.1.9 das MC-Verfahren geändert – und damit vereinfacht –, indem alle MC-Werte der Ergebnisgröße nun in einem Array gespeichert werden. Die MC-Simulation liefert nun für jede der drei oben genannten Verteilungen Arrays von bis zu 2 000 000 MC-Werten. Aus diesen Arrays werden Mittelwert und Standardabweichung leicht berechnet. Quantile werden mit einer verteilungsfreien Methode geschätzt, wofür die Arrays zunächst sortiert werden müssen. Nur zum Zweck der grafischen Darstellung als Histogramm müssen die MC-Werte in 20 000 Bins („multi-channel“) einsortiert werden; die Grenzen der Histogramme werden nach der MC-Simulation bestimmt – und nicht vorher. Diese Änderungen machten das MC-Verfahren im Code leichter handhabbar.
Schätzwerte nach Bayes
Für die Schätzung von Mittelwert, Standardabweichung und unterer und oberer Vertrauensgrenze nach der Bayes-Methode wird nur die bei null abgeschnittene Verteilung verwendet; Werte unter null werden nicht verwendet und nicht für die Gesamtzahl der Werte berücksichtigt. Die Vertrauensgrenzen werden als unteres und oberes Quantil der Verteilung geschätzt. Die Gesamtzahl der in einem Lauf berücksichtigten Werte ist nur etwa N/2.
Mit Version 1.03 wurde im Dialog „Results”, MC-Abschnitt, eine Option ergänzt, mit der sich ein spezielles Paar von Überdeckungsgrenzen berechnen lässt, das den kürzesten Abstand hat (Bayes’sches Überdeckungsintervall kürzester Länge), statt der symmetrischen Vertrauensgrenzen. Testfall: Neutron-Dose-Cox-2006_EN.txp. Die Aktivierung dieser Option führt nicht zu einer wesentlichen Verlängerung der Simulationsdauer.
Eingangsgrößen-Werte, die einer asymmetrischen oder Rechteck-Verteilung zugeordnet sind, können zu einer signifikanten Asymmetrie der Verteilung der Ergebnisgröße führen. Im Fall der Erkennungsgrenze kann dies eine gewisse Abweichung des Mittelwerts von null bewirken.
Zunächst wird eine Abweichung von einer erwarteten, symmetrisch zu null liegenden Verteilung geprüft. Dazu wird der von null abweichende Mittelwert y1 mit der MC-Unsicherheit des Mittelwerts, u(y1)/√N verglichen (siehe unten). Wenn dieses Verhältnis 0.02 überschreitet, oder 0.150 falls PMLE angewendet wird, gilt Folgendes:
\(\frac{y_{1}}{u\left( y_{1} \right)/\sqrt{N}} > 0.02\ \)
wird für die Erkennungsgrenze eine Iteration mit der Sekantenmethode durchgeführt, die den Mittelwert näher zu null verschiebt. Falls erforderlich, werden bis zu 12 Schritte ausgeführt, von denen jeder eine vollständige MC-Simulation erfordert; dies führt zu steigendem Rechenaufwand. Falls keines der Verhältnisse unter den geltenden Grenzwert fällt, wird die Verteilung mit dem kleinsten Verhältnis aus denen der 12 Schritte ausgewählt, aus der dann die Erkennungsgrenze berechnet wird. y1 kann typischerweise um eins bis zwei Größenordnungen reduziert werden; es kann jedoch vorkommen, dass y1 kaum um mehr als einen Faktor 10 reduziert wird.
Erkennungsgrenze
Für die Erkennungsgrenze erfolgt eine Modifikation dergestalt, dass der „wahre Wert” der Nettozählrate (und damit auch der Aktivität) gleich null gesetzt wird. Es resultiert eine Verteilung der damit simulierten Einzelwerte, die zu etwa 50% im negativen Bereich liegt. Es erfolgt keine Abschneidung bei null. Das hieran ermittelte obere (1-\(\alpha\))-Quantil stellt den erhaltenen Wert der Erkennungsgrenze dar.
Nachweisgrenze
Die Ermittlung der Nachweisgrenze ist der zeitaufwändigste Teil der Simulation, da hierbei die Verteilung in einem iterativen Vorgang mehrere Male, jeweils nach Erreichen der Gesamtanzahl von Einzelwerten, durch Änderung des Mittelwerts der Verteilung verschoben wird. Ziel der schrittweisen Verschiebung ist, dass das (untere) ß-Quantil dieser Verteilung dem zuvor bestimmten Wert der Erkennungsgrenze immer näherkommt. Das Iterationsverfahren basiert auf dem Bisektionsverfahren, wobei jedoch nicht eine simple Halbierung eines Intervalls erfolgt, sondern die Teilung durch lineare Interpolation zwischen seinen beiden Grenzen erfolgt.
Negative values are explicitly considered in these calculations.
Die Motivation, bei Erkennungsgrenze und Nachweisgrenze deren negative Anteile ihrer Verteilungen nicht zu verwerfen, besteht darin, dass der primär erhaltene Messwert der Ergebnisgröße direkt mit der Erkennungsgrenze verglichen werden soll. Würde man die negativen Anteile verwerfen, müsste der primäre Messwert, der ja negativ sein kann, erst eine zum Abschneiden analoge Transformation erfahren, bevor der Vergleich wieder möglich wäre.
Um die Verteilungen im Falle der Bayes-Schätzung nicht-negativ zu machen, ist dies möglich, nachdem ein Vergleich zwischen primärer Ergebnisgröße und der Erkennungsgrenze durchgeführt wurde und zu dem Schluss geführt hat, dass die Annahme eines von null verschiedenen Aktivitätswerts in der Probe zutrifft.
Schätzung der MC-Unsicherheiten der Kennwerte
Eine MC-Simulation mit nur einem einzelnen Run ergab bislang keine Abschätzungen der Unsicherheiten der Kennwerte. Darüber hinaus sind auch die bei kleiner Run-Anzahl aus der Spreizung zwischen den Runs erhaltenen Abschätzungen nicht sehr zuverlässig.
Da die erhaltenen MC-Verteilungen in der Regel normal-verteilt sind, können jedoch Unsicherheiten der Kennwerte wie folgt geschätzt werden (siehe z.B. Barlow, 1999):
Kenngröße: |
Breitenparameter: |
Formel für die (absolute) Unsicherheit: |
|---|---|---|
Wert der Ergebnisgröße |
\(\sigma\) |
\(\frac{\sigma}{\sqrt{N}}\) |
Uncertainty |
\(\sigma\) |
\(\frac{\sigma}{\sqrt{2N}}\) |
die untere Vertrauensgrenze |
\(\sigma\) |
\(\frac{\sigma}{\varphi\left( \Phi^{-1}(1 - \gamma/2) \right)}\sqrt{\frac{(1 - \gamma/2) \cdot \gamma/2}{N}}\) |
die obere Vertrauensgrenze |
\(\sigma\) |
dito |
Erkennungsgrenze |
\(\sigma^* = \frac{y^*}{k_{1 - \alpha}}\) |
\(u_{MC}\left( y^{*} \right) = \frac{\sigma^*}{\varphi\left( \Phi^{-1}(1 - \alpha) \right)}\sqrt{\frac{(1 - \alpha) \cdot \alpha}{N}}\) |
Nachweisgrenze |
\(\sigma^{\#} = \frac{y^{\#} - y^*}{k_{1 - \beta}}\) |
\(u_{MC}\left( y^{\#} \right) = \sqrt{u_{MC}^{2}\left( y^{*} \right) + u^{\#\ 2}}\), with \(u^{\#} = \frac{\sigma^{\#}}{\varphi\left( \Phi^{-1}(1 - \beta) \right)}\sqrt{\frac{(1 - \beta) \cdot \beta}{N}}\) |
(N: Anzahl der MC-simulierten Einzelmessungen; ϕ(.) und Φ(.): Dichte- bzw. Verteilungsfunktion der Standardnormalverteilung; zu den Wahrscheinlichkeiten α, β und γ siehe Dialog Optionen).
Die nach dieser Tabelle berechneten MC-Unsicherheiten werden im MC-Teil des TABs „Results” als relative Werte in Prozent ausgegeben, jedoch nur bei einem einzelnen Run.
Grafische Darstellungen
Die bei den drei vorstehenden Punkten erzeugten Verteilungen werden während des Ablaufs der Simulation in einem separaten Fenster auch grafisch als Histogramm dargestellt. Die Verteilungen zeigen während der r Runs die aus den bereits erfolgten Runs akkumulierte Verteilung, die sich schon nach wenigen Runs „stabilisiert”. Bei den Runs zur Nachweisgrenze wird erst nach Beendigung aller Runs die akkumulierte Verteilung dargestellt. Die X-Achse (Abszisse) entspricht den Werten der ausgewerteten Größe, die im Titel des jeweiligen Graphs bezeichnet ist, die Y-Achse (Ordinate) stellt den Wertebereich der Wahrscheinlichkeit dar.
Beispiel des separaten Fensters mit den MC-Graphiken:
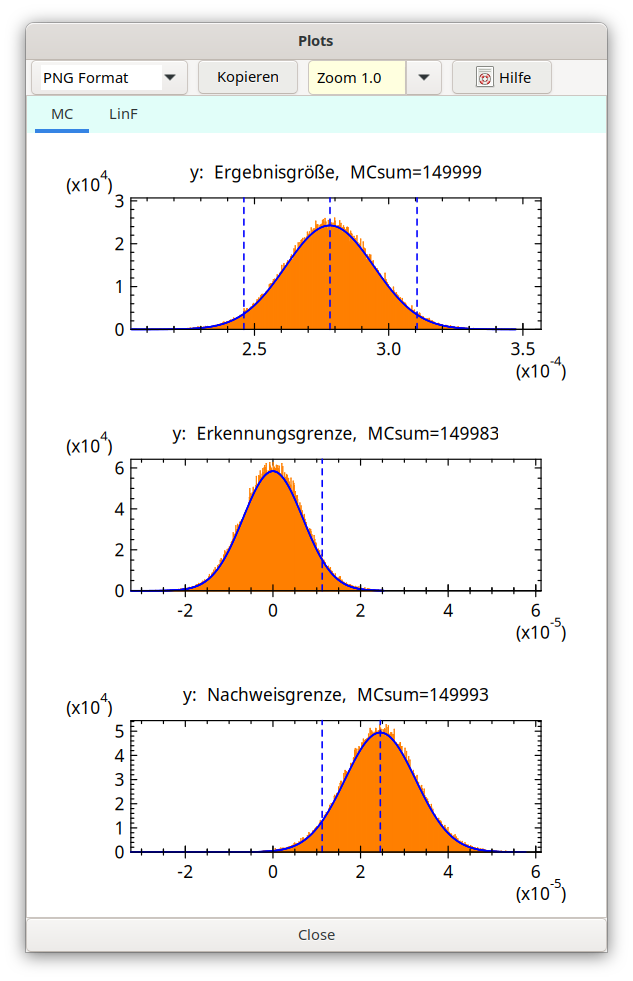
Vertikale grüne Linien in den Grafiken markieren, jeweils von links nach rechts in den Verteilungen, folgende Werte:
Verteilung Werte
Ergebnisgröße untere Vertrauensgrenze, bester Schätzwert (Bayes), obere Vertrauensgrenze
Erkennungsgrenze ihr Wert
Nachweisgrenze Erkennungsgrenze, Nachweisgrenze
Nach jedem einzelnen MC-Run wird diejenige Gauß-Kurve, die dem Ergebnis des analytischen Verfahrens entspricht, in blauer Farbe geplottet.
Hinweis: Das separate Fenster mit den MC-Grafiken bleibt nach Abschluss der MC-Simulationsberechnungen erhalten. Dies ermöglicht eine zusätzliche Inspektion der unter den verschiedenen TABs gezeigten Daten sowie den Aufruf eines Ergebnisberichts und die anschließende Rückkehr zum TAB „Results” mit diesem Fenster. Falls während dieses Schritts Daten oder Optionen geändert werden mit der Folge, dass die ursprünglichen, der MC-Simulation zugrunde liegenden Annahmen nicht mehr gültig sind, wird dieses MC-Fenster geschlossen. Dies geschieht auch, wenn Berechnungen im TAB “Values, Uncertainties” oder durch den Wechsel vom TAB “Values, Uncertainties” zum TAB TAB „Unsicherheiten-Budget“ initiierte Berechnungen aufgerufen werden.
